LoxiLB 实战:k3s 上的 eBPF LoadBalancer、PodIP 分发与 BGP 通告
LoxiLB 0.9.8.8 + kube-loxilb:单节点实测、端点模式对比与 BGP 路由撤销
自建 Kubernetes 最烦的一件事,是 Service type=LoadBalancer 没有云厂商给你分配 VIP。MetalLB 能补上 L2/BGP 通告,但数据面还是走内核协议栈;LoxiLB 换了个思路,把转发逻辑放进 eBPF,由 kube-loxilb 监听 Service 和 EndpointSlice,把规则下发给 LoxiLB。
这篇在单节点 k3s 上把 in-cluster 模式跑了一遍:VIP 分配、NodePort 与 PodIP 两种端点模式、轮询分发、端点伸缩,最后用 BIRD 做 BGP 对端,验证 VIP 前缀的通告和撤销。
实测:k3s v1.32.3 单节点、in-cluster 模式、LoxiLB 0.9.8.8、kube-loxilb(2026-11-16 的 latest 镜像)、LoadBalancer VIP、NodePort 后端 + onearm、PodIP 后端 + default、轮询分发、端点伸缩、BGP 通告与撤销、eBPF tc 程序挂载。
未实测:External 模式、多节点 HA、BFD、DSR 模式、VyOS 实际对接、主动探测的故障注入。PodIP 后端配 onearm/fullnat 在本次单节点环境里外部访问失败,原因未定位,文中如实记录。
为什么自建集群需要一个 LoadBalancer
不用云厂商的托管 LB,通常会遇到三个问题:
- 没有外部 IP:
type: LoadBalancer的 Service 一直停在Pending,只能退化成 NodePort。 - VIP 不可达:即使分配了地址,上游网络不知道这个地址在哪,需要 ARP 或 BGP 把它通告出去。
- 组件太多:MetalLB 管 VIP,kube-proxy 管转发,再做健康检查还要加一层,排障时要在几个组件之间对日志。
LoxiLB 把这些收进一个二进制:eBPF 数据面负责 NAT 和调度,内置 goBGP 负责路由通告,kube-loxilb 负责把 Kubernetes 的 Service 翻译成 LoxiLB 规则。
LoxiLB 的组件
| 层面 | 组件 | 职责 |
|---|---|---|
| 数据面 | eBPF 程序 | 连接跟踪、NAT、端点选择、会话保持、健康探测 |
| 控制面 | LoxiLB 进程 | 装载 eBPF 规则,维护会话表,内置 goBGP,暴露 REST API(11111 端口) |
| K8s 集成 | kube-loxilb | 监听 Service/EndpointSlice,做 IPAM 和策略计算,通过 REST API 下发规则 |
这次部署在 k3s 的日志里看到的是 tc: bpf attach OK for ens18,也就是 eBPF 程序挂在 tc hook 上,不是 XDP。具体挂载点取决于版本和部署模式,部署后看日志确认最稳。
从创建 Service 到数据包转发,链路大致是:
sequenceDiagram
    participant User as kubectl
    participant API as K8s API Server
    participant KL as kube-loxilb
    participant LB as LoxiLB 控制面
    participant DP as eBPF 数据面
    participant BGP as goBGP
    participant Peer as BGP 对端

    User->>API: 创建 Service(type=LoadBalancer)<br/>loadBalancerClass: loxilb.io/loxilb
    API-->>KL: Watch Service / EndpointSlice
    KL->>KL: IPAM 分配 VIP<br/>解析 lbmode、usepodnetwork 等注解
    KL->>LB: REST API 下发 LB 规则
    LB->>DP: 更新 BPF Map
    LB->>BGP: 通告 VIP 前缀
    BGP->>Peer: BGP UPDATE(VIP/32)
    Note over DP: 数据包进入 ens18<br/>查 BPF Map 后 DNAT<br/>转发到 NodePort 或 PodIP
实验环境与实测范围
- Debian 12 虚拟机,4 vCPU / 5.8 GiB 内存,内核 6.1.0-23-cloud-amd64
- k3s v1.32.3+k3s1,单节点,containerd 2.0.4
- LoxiLB v0.9.8.8,kube-loxilb 使用 2026-11-16 的 latest 镜像
- VIP:
10.31.0.244,和节点10.31.0.144/24同网段 - 测试负载:
ghcr.io/loxilb-io/nginx:stable,3 个副本
选择 in-cluster 模式,原因是实验环境只有一台机器。LoxiLB 以 DaemonSet 跑在节点上,kube-loxilb 不配 --loxiURL,靠 headless Service 自动发现 LoxiLB。External 模式(LoxiLB 用 Docker 跑在集群外、kube-loxilb 通过 --loxiURL 连接)本次没有实测,命令放在生产化一节作为参考。
VIP 选同网段的空闲地址,部署前先确认没有被占用:
for ip in 10.31.0.244 10.31.0.245 10.31.0.246; do
  ping -c 1 -W 1 "$ip" >/dev/null 2>&1 && echo "$ip used" || echo "$ip free"
done
部署 in-cluster 模式
k3s 已经装好,直接应用 LoxiLB 和 kube-loxilb 的清单。官方 k3s-incluster 示例里的 LoxiLB DaemonSet 长这样,关键参数都保留了:
apiVersion: apps/v1
kind: DaemonSet
metadata:
  name: loxilb-lb
  namespace: kube-system
spec:
  selector:
    matchLabels:
      app: loxilb-app
  template:
    metadata:
      labels:
        app: loxilb-app
    spec:
      hostNetwork: true
      hostPID: true
      dnsPolicy: ClusterFirstWithHostNet
      initContainers:
        - name: mkllb-cgroup
          # 准备 cgroup,略
      containers:
        - name: loxilb-app
          image: ghcr.io/loxilb-io/loxilb:v0.9.8.8
          imagePullPolicy: IfNotPresent
          command:
            - /root/loxilb-io/loxilb/loxilb
            - --bgp
            - --egr-hooks
            - --blacklist=cni[0-9a-z]|veth.|flannel.|cali.|tunl.|vxlan[.]calico|docker|br-
            - --localsockpolicy
          ports:
            - containerPort: 11111
            - containerPort: 179
            - containerPort: 50051
          securityContext:
            privileged: true
            capabilities:
              add: ["SYS_ADMIN"]
完整清单还包括 affinity、tolerations 和 volumes,见文末的官方 k3s in-cluster quick start;这里只摘和网络行为相关的部分。
参数说明:
| 参数 | 作用 |
|---|---|
--bgp |
启用内置 goBGP,用于通告 VIP |
--egr-hooks |
允许同一节点上的 Pod 作为后端 |
--blacklist |
不把 eBPF 程序挂到 CNI、Docker、veth 等接口上 |
--localsockpolicy |
处理本机发起的连接,单节点测试时会影响本机访问 VIP 的行为 |
--blacklist 里额外加了 docker 和 br-,因为这台机器还跑着 Docker 服务,不希望 LoxiLB 去碰 Docker 网桥。官方示例只列了 CNI 相关接口,按环境补全就行。
kube-loxilb 的启动参数:
args:
  - --cidrPools=defaultPool=10.31.0.244/32
  - --setRoles=0.0.0.0
- --monitor| 参数 | 说明 |
|---|---|
--cidrPools |
VIP 池,这里只留一个地址 |
--setRoles |
单节点仲裁,0.0.0.0 表示由 kube-loxilb 自己选主 |
--monitor |
启用后端存活探测 |
应用后检查 Pod:
sudo k3s kubectl apply -f loxilb.yml
sudo k3s kubectl apply -f kube-loxilb.yml

sudo k3s kubectl -n kube-system get pods | grep -E 'loxilb|NAME'
# kube-loxilb-85c889d68c-kkjjq   1/1   Running   0   15s
# loxilb-lb-n4khk                1/1   Running   0   15s
如果 kube-loxilb 日志里出现 service cannot be added because there are no loxilb instances,先等几秒。kube-loxilb 启动时 LoxiLB 可能还没就绪,这条错误是发现阶段的正常重试,LoxiLB 的 headless Service 有端点后会自动恢复。
第一个 LoadBalancer Service
创建 3 个 nginx 副本,每个 Pod 把自己的主机名写进首页,方便看分发结果:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: tcp-onearm-test
spec:
  replicas: 3
  selector:
    matchLabels:
      what: tcp-onearm-test
  template:
    metadata:
      labels:
        what: tcp-onearm-test
    spec:
      containers:
        - name: nginx
          image: ghcr.io/loxilb-io/nginx:stable
          imagePullPolicy: IfNotPresent
          command: ["/bin/sh", "-c"]
          args:
            - echo "pod $HOSTNAME" > /usr/share/nginx/html/index.html && exec nginx -g 'daemon off;'
          ports:
            - containerPort: 80
Service 用官方示例的 onearm 模式,后端走 NodePort:
apiVersion: v1
kind: Service
metadata:
  name: tcp-lb-onearm
  annotations:
    loxilb.io/liveness: "yes"
    loxilb.io/lbmode: "onearm"
spec:
  externalTrafficPolicy: Local
  loadBalancerClass: loxilb.io/loxilb
  selector:
    what: tcp-onearm-test
  ports:
    - port: 56002
      targetPort: 80
      nodePort: 30001
  type: LoadBalancer
loadBalancerClass: loxilb.io/loxilb 是关键。加上这个字段后,Service 会交给 kube-loxilb 处理,不会再落到 k3s 自带的 Klipper 上;Traefik 自己的 Service 不受影响。
sudo k3s kubectl apply -f demo-onearm.yaml
sudo k3s kubectl get svc tcp-lb-onearm
# NAME            TYPE           CLUSTER-IP    EXTERNAL-IP       PORT(S)           AGE
# tcp-lb-onearm   LoadBalancer   10.43.57.16   llb-10.31.0.244   56002:30001/TCP   12s
EXTERNAL-IP 显示成 llb-10.31.0.244,实际 VIP 是后面的地址。从同网段的另一台机器访问:
for i in $(seq 1 12); do
  curl -s http://10.31.0.244:56002/
done | sort | uniq -c
#   3 pod tcp-onearm-test-558d88cd5d-5v7xc
#   4 pod tcp-onearm-test-558d88cd5d-87ntv
#   5 pod tcp-onearm-test-558d88cd5d-ftp47
三个 Pod 都分到了流量。LoxiLB 侧看到的端点不是 PodIP,而是节点的 NodePort:
POD=$(sudo k3s kubectl -n kube-system get pod -l app=loxilb-app -o jsonpath='{.items[0].metadata.name}')
sudo k3s kubectl -n kube-system exec "$POD" -c loxilb-app -- \
  loxicmd get lb -o wide
# 输出节选(省略 SEC IPS、MARK、COUNTERS 等列)
# | 10.31.0.244 | 56002 | tcp | default_tcp-lb-onearm:llb-inst0 | rr | onearm | 10.31.0.144 | 30001 | active |
这条路径里,LoxiLB 只把 VIP 流量送到 10.31.0.144:30001,Pod 之间的分发由 kube-proxy 完成。对单节点没问题,但多节点时 LoxiLB 无法直接感知 Pod 的分布。
PodIP 端点与轮询分发
如果希望 LoxiLB 直接按 Pod 分发,加 loxilb.io/usepodnetwork: "yes",端点会变成 PodIP + targetPort:
metadata:
  name: tcp-lb-podnet-default
  annotations:
    loxilb.io/liveness: "yes"
    loxilb.io/lbmode: "default"
    loxilb.io/usepodnetwork: "yes"
spec:
  externalTrafficPolicy: Local
  loadBalancerClass: loxilb.io/loxilb
  selector:
    what: tcp-onearm-test
  ports:
    - port: 56004
      targetPort: 80
      nodePort: 30003
type: LoadBalancerfor i in $(seq 1 12); do
curl -s http://10.31.0.244:56004/
done | sort | uniq -c
# 4 pod tcp-onearm-test-558d88cd5d-5v7xc
# 4 pod tcp-onearm-test-558d88cd5d-87ntv
# 4 pod tcp-onearm-test-558d88cd5d-ftp4712 个请求正好 4/4/4。loxicmd get lb 里能看到三个 PodIP 端点:
sudo k3s kubectl -n kube-system exec "$POD" -c loxilb-app -- \
  loxicmd get lb -o wide
# 输出节选(省略部分列)
# | 10.31.0.244 | 56004 | tcp | default_tcp-lb-podnet-default:llb-inst0 | rr | default |
# |             |       |     |                                                 |    |         | 10.42.0.3 | 80 |
# |             |       |     |                                                 |    |         | 10.42.0.4 | 80 |
# |             |       |     |                                                 |    |         | 10.42.0.6 | 80 |
本机访问会拿到 404
在 LoxiLB 所在节点上直接 curl 10.31.0.244:56004,返回的是 Go 默认的 404 page not found,不是 nginx 的页面。从现象看,是 --localsockpolicy 接管了本机发起的连接,单节点测试时本机访问 PodIP 后端会走本地 socket 策略。
换一台同网段的机器访问就正常。这个现象容易误判成 VIP 或规则没生效,排障时先区分“本机访问”和“外部访问”。
四种组合的实测结果
| 后端 | lbmode | 外部访问 | 说明 |
|---|---|---|---|
| NodePort | onearm | 正常 | 官方示例,单节点可用 |
| PodIP | default | 正常 | 12 个请求 4/4/4 |
| PodIP | onearm | 失败 | 外部连接超时,原因未定位 |
| PodIP | fullnat | 失败 | 外部连接超时,原因未定位 |
后两行不是配置写错:loxicmd get lb 里规则和端点都在,get ep 也显示 ok,但外部连接就是不通。单节点 + 本地 socket 策略可能是原因之一,本次没有继续深挖。生产环境如果要用 fullnat,建议先在多节点环境验证,或者直接走官方示例的 NodePort 后端。
端点健康与伸缩
loxilb.io/liveness: "yes" 会让 LoxiLB 对端点做 TCP/HTTP 探测。这里没有做主动故障注入,只验证了 EndpointSlice 变化时规则会不会跟着更新。
把副本从 3 缩到 2:
sudo k3s kubectl scale deploy tcp-onearm-test --replicas=2
sleep 8
sudo k3s kubectl -n kube-system exec "$POD" -c loxilb-app -- \
  loxicmd get ep
# 输出节选
# | 10.42.0.3   | ... | ok |
# | 10.42.0.4   | ... | ok |
10.42.0.2 从端点列表里消失。再扩回 3,新 Pod 10.42.0.6 会自动加回来。伸缩后端点列表在几秒内更新,本次没有测具体收敛时间。对 HTTP 短连接来说这个速度够用;长连接场景要考虑会话保持和客户端重连。LoxiLB 的 conntrack 在单实例上维护,跨实例故障切换时已有连接大概率会断,本次没有做故障切换测试。
用 BGP 通告 VIP
VIP 只在 LoxiLB 节点本地有效,上游路由器不知道 10.31.0.244 在哪。生产环境一般用 BGP 把 VIP 前缀通告给核心路由器,LoxiLB 内置 goBGP,kube-loxilb 负责配置。
kube-loxilb 在原有参数基础上加三个 BGP 参数:
args:
  - --cidrPools=defaultPool=10.31.0.244/32
  - --setRoles=0.0.0.0
  - --monitor
  - --setBGP=65100
  - --extBGPPeers=192.168.200.2:65000
- --listenBGPPort=1791| 参数 | 说明 |
|---|---|
--setBGP=65100 |
LoxiLB 的 AS 号 |
--extBGPPeers |
对端地址和 AS 号,格式 IP:AS |
--listenBGPPort=1791 |
LoxiLB 的 BGP 监听端口;对端占用 179 时改这里 |
实验室 BGP 对端
实验环境没有 VyOS,用 BIRD 2.0.12 在一个 network namespace 里扮演上游路由器。veth 用独立的 /30 网段,不要和节点所在的 /24 重叠,否则内核会优先走 veth 的路由,把整个网段的回包黑洞掉。这个问题在调试时真实踩到过,VM 直接失联,只能从 PVE 的 guest agent 进去删路由。
sudo ip netns add bgpns
sudo ip link add veth-bgp type veth peer name veth-bgp-ns
sudo ip link set veth-bgp-ns netns bgpns
sudo ip addr add 192.168.200.1/30 dev veth-bgp
sudo ip link set veth-bgp up
sudo ip netns exec bgpns ip addr add 192.168.200.2/30 dev veth-bgp-ns
sudo ip netns exec bgpns ip link set veth-bgp-ns up
sudo ip netns exec bgpns ip link set lo up
sudo ip netns exec bgpns ip route add 10.31.0.144/32 via 192.168.200.1
BIRD 配置:
router id 192.168.200.2;
protocol device {}
protocol bgp loxilb {
  local as 65000;
  neighbor 10.31.0.144 as 65100 port 1791;
  multihop 2;
  ipv4 {
    import all;
    export none;
  };
}
启动 BIRD,让它只在 netns 里监听:
sudo ip netns exec bgpns bird -c /etc/bird/bgpns.conf \
  -s /run/bird-bgpns.ctl -P /run/bird-bgpns.pid -u root
路由通告与撤销
先看 BGP 邻居:
sudo ip netns exec bgpns birdc -s /run/bird-bgpns.ctl \
  show protocols loxilb
# Name       Proto      Table      State  Since         Info
# loxilb     BGP        ---        up     01:25:08.703  Established
再看 LoxiLB 侧的邻居:
POD=$(sudo k3s kubectl -n kube-system get pod -l app=loxilb-app -o jsonpath='{.items[0].metadata.name}')
sudo k3s kubectl -n kube-system exec "$POD" -c loxilb-app -- loxicmd get bgpneigh
# |     PEER      |  AS   | UP/DOWN  |    STATE    |
# | 192.168.200.2 | 65000 | 00:04:18 | ESTABLISHED |
BIRD 收到的路由:
sudo ip netns exec bgpns birdc -s /run/bird-bgpns.ctl \
  show route
# 10.31.0.244/32  unreachable [loxilb 01:25:48.126 from 10.31.0.144] * (100) [i]
unreachable 是因为 BIRD 没有解析下一跳的路由,不影响 BGP 通告本身。show route all 里能看到 BGP.as_path: 65100 和 BGP.next_hop: 10.31.0.144。
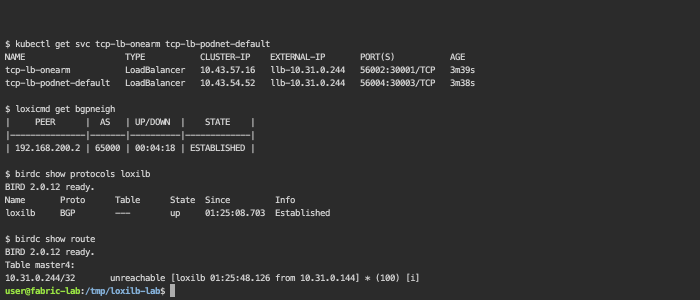
撤销测试:把所有使用该 VIP 的 Service 删掉,BIRD 的路由表变空;重新 apply 后路由回来。
sudo k3s kubectl delete svc tcp-lb-onearm tcp-lb-podnet \
  tcp-lb-podnet-default tcp-lb-podnet-fullnat
sleep 6
sudo ip netns exec bgpns birdc -s /run/bird-bgpns.ctl \
  show route
# BIRD 2.0.12 ready.
# Table master4:

sudo k3s kubectl apply -f demo-onearm.yaml
sudo k3s kubectl apply -f demo-podnet-modes.yaml
sleep 8
sudo ip netns exec bgpns birdc -s /run/bird-bgpns.ctl \
  show route
# 10.31.0.244/32  unreachable [loxilb ...] * (100) [i]
这说明 VIP 前缀是跟着 Service 生命周期通告和撤销的,不是静态写死。
loxicmd create bfd 的用法。本次 BGP 用的是多跳会话,BFD 的单跳和多跳模式需要对齐,没有继续做。生产环境用 BFD 前,建议先在测试环境确认 loxicmd get bfd 和路由器侧的会话状态。VyOS 配置参考
下面是 VyOS 侧的配置,来自官方文档和常见实践,本次没有实际对接,只作为参考:
configure
set protocols bgp system-as '65000'
set protocols bgp parameters router-id '10.31.0.1'
set protocols bgp neighbor 10.31.0.144 remote-as '65100'
set protocols bgp neighbor 10.31.0.144 description 'LoxiLB'
set protocols bgp neighbor 10.31.0.144 address-family ipv4-unicast
set protocols bgp address-family ipv4-unicast maximum-paths ebgp '2'
commit
save
实际部署时还要加 prefix-list,只接受 VIP 网段,避免 LoxiLB 把其他路由泄漏进来。
NAT 模式怎么选
LoxiLB 支持多种 NAT 模式,选错模式是 VIP 不通的常见原因。下面这张表是模式说明,最后一列标注本次是否实测:
| 模式 | 源地址改写 | 目标地址改写 | 本次实测 |
|---|---|---|---|
| default | 不改写 | VIP -> PodIP | PodIP 后端可用 |
| onearm | 改为 LoxiLB 接口 IP | VIP -> PodIP / NodePort | NodePort 后端可用 |
| fullnat | 改为 VIP | VIP -> PodIP | 未跑通 |
| dsr | 不改写 | 通过封装传递 | 未测 |
| fullproxy | L7 代理 | L7 代理 | 未测 |
选型建议:
- 同网段、希望保留客户端源 IP:
default+ PodIP 后端 - 单节点或后端用 NodePort:
onearm - 跨网段、回程路由不好控制:
fullnat,但先在目标环境验证 - 大带宽、回程不想经过 LB:
dsr,本次没有环境验证
生产化注意事项
多节点 HA:至少两个 LoxiLB 实例,配合 BGP ECMP 和 BFD。LoxiLB 的 conntrack 不跨实例同步,故障切换后已有连接会断,HTTP 短连接影响不大,长连接需要客户端重连。
External 模式:LoxiLB 用 Docker 跑在集群外的节点上,kube-loxilb 通过 --loxiURL 连接。官方示例:
docker run -d --restart unless-stopped \
  --name loxilb \
  --privileged --net=host \
  ghcr.io/loxilb-io/loxilb:v0.9.8.8 \
  --bgp --egr-hooks
kube-loxilb 的 --loxiURL 指向 LoxiLB 的 11111 端口。External 模式适合把 LB 节点放在 DMZ,本次没有验证。
安全:LoxiLB 的 REST API 默认没有认证,11111 端口只允许 kube-loxilb 所在网段访问。BGP 对端建议配 MD5 和 TTL Security,prefix-list 只放行 VIP 网段。
监控:官方文档提到 LoxiLB 暴露 Prometheus 指标,路径是 /netlox/v1/config/metrics,本次没有接入 Prometheus 验证。重点看 LB 规则数、端点健康、BGP 邻居状态。Blackbox Exporter 对 VIP 做主动拨测也可以补上。
排障记录
1. kube-loxilb 报 no loxilb instances
启动初期正常,等 LoxiLB Pod 就绪后会自动恢复。如果一直不恢复,检查 loxilb-lb-service 的 Endpoints 是否有地址,以及 kube-loxilb 能不能访问 10.31.0.144:11111。
2. 删除 loxilb Pod 后新 Pod CrashLoopBackOff
LoxiLB 的 DaemonSet 开了 hostPID: true,删 Pod 时 gobgpd 可能作为孤儿进程留在宿主机上,继续占用 1791 和 50052 端口,新 Pod 启动时冲突。排查:
pgrep -a gobgpd
# 356359 gobgpd --api-hosts=127.0.0.1:50052
sudo kill 356359
sudo k3s kubectl -n kube-system delete pod -l app=loxilb-app
杀掉孤儿进程后新 Pod 正常启动。手动删 LoxiLB Pod 前先看一眼 pgrep -a gobgpd,能省不少时间。
3. VIP 分配了但外部访问不通
按顺序检查:
POD=$(sudo k3s kubectl -n kube-system get pod -l app=loxilb-app -o jsonpath='{.items[0].metadata.name}')

# 规则是否下发
sudo k3s kubectl -n kube-system exec "$POD" -c loxilb-app -- \
  loxicmd get lb -o wide

# 端点是否健康
sudo k3s kubectl -n kube-system exec "$POD" -c loxilb-app -- \
  loxicmd get ep

# 服务状态
sudo k3s kubectl get svc <name>

# BGP 对端是否收到路由
sudo ip netns exec bgpns birdc -s /run/bird-bgpns.ctl \
  show route

# 抓包
sudo tcpdump -i ens18 host 10.31.0.244 -nn -c 20常见原因:loadBalancerClass 拼错、VIP 池耗尽、BGP 没建立、lbmode 和网络拓扑不匹配、端点被标记为 inactive。
4. 本机 curl VIP 返回 404
从现象看,是 --localsockpolicy 接管了本机连接,PodIP 后端在本机访问时可能返回 404。换外部机器验证,或者用 NodePort 后端做本机测试。
5. 部署后整个网段失联
如果给 veth 或 dummy 接口配了和节点相同网段的地址,内核可能优先走新接口的路由,把回包黑洞掉。检查 ip route 里有没有和主网卡同网段、metric 更低的条目。调试 BGP 时 veth 用独立的 /30 网段,能避开这个问题。
参考
如果你觉得这篇文章对你有所帮助,欢迎赞赏~
赞赏